Completed
AWS CMDB
Sistema de Gestión de Infraestructura Cloud Multi-Cuenta
AWS CMDB es una plataforma de gestión de configuración diseñada y desarrollada íntegramente para centralizar, monitorizar y auditar la infraestructura cloud de una organización enterprise distribuida en varias cuentas AWS y multiples servicios distintos. El sistema recopila automáticamente el inventario completo de recursos, evalúa su estado contra reglas de negocio configurables, genera alertas accionables y expone todo a través de una interfaz web moderna y una API REST documentada. El proyecto nació de una necesidad real: en entornos cloud de gran escala, la visibilidad sobre qué recursos existen, en qué estado están y si cumplen las políticas corporativas es un problema no resuelto por las herramientas nativas de AWS cuando se trabaja con múltiples cuentas. Este sistema lo resuelve de forma elegante, autónoma y extensible.
El problema que resuelve
Gestionar infraestructura cloud en una organización enterprise con docenas de equipos, múltiples entornos (dev, nonprod, prod) y cuentas AWS separadas por dominio de negocio genera una complejidad operativa enorme. Las preguntas más básicas se vuelven difíciles de responder:
- ¿Cuántas instancias EC2 tenemos en producción y cuáles están paradas?
- ¿Hay bases de datos RDS sin Multi-AZ en entornos críticos?
- ¿Qué Lambdas usan runtimes obsoletos que AWS va a deprecar?
- ¿Algún bucket S3 tiene acceso público habilitado?
- ¿Qué recursos se verán afectados por el próximo evento de mantenimiento de AWS?
AWS CMDB responde a todas estas preguntas en tiempo real, de forma centralizada y sin necesidad de acceder a cada cuenta individualmente.
Arquitectura del sistema
El sistema sigue una arquitectura de tres capas perfectamente desacopladas: FRONTEND (Angular) BACKEND (FastAPI + Python) AWS (multiples cuentas)
El backend actúa como único punto de entrada: recopila datos de AWS, los persiste en SQLite, los evalúa contra reglas de alerta y los sirve a través de una API REST que el frontend consume. El frontend compilado se sirve directamente desde el propio backend, lo que simplifica el despliegue a un único proceso.
Backend — Python / FastAPI
Recolección multi-cuenta con asunción de roles IAM
Uno de los retos técnicos más interesantes del proyecto fue implementar la recolección de recursos en múltiples cuentas AWS sin necesidad de credenciales estáticas. El sistema utiliza el mecanismo nativo de AWS STS AssumeRole: la instancia EC2 donde corre el backend tiene un IAM Instance Profile con permisos para asumir roles en las cuentas objetivo. Cada rol en las cuentas destino tiene permisos de solo lectura sobre los servicios a monitorizar.
El `AWSSessionManager` gestiona el ciclo de vida de las sesiones, incluyendo renovación automática de credenciales temporales antes de su expiración.
Colectores especializados
Cada servicio AWS tiene su propio colector independiente que sabe exactamente qué atributos extraer y cómo normalizarlos al esquema común del CMDB. Esto permite añadir nuevos servicios sin tocar el código existente.
Los colectores más complejos incluyen lógica adicional:
- EC2 Collector: Detecta automáticamente el middleware instalado en cada instancia (Apache, Nginx, Tomcat, MySQL, PostgreSQL, Python, Java, Node.js) inspeccionando los tags y metadatos. También extrae la política de offhours de Cloud Custodian (`c7n_maid_offhours`) para validar su formato.
- EKS Collector: Agrega métricas de utilización de CPU y memoria de los nodos del clúster mediante CloudWatch, calculando porcentajes de uso en tiempo real.
- DMS Collector: Recopila instancias de replicación, endpoints y tareas de migración como entidades separadas, extrayendo métricas de latencia CDC (Change Data Capture) para detectar retrasos en la replicación.
- ALB Collector: Obtiene el estado de salud de los target groups, calculando tasas de error y latencia media de respuesta.
- AWS Health Collector: Recopila eventos de mantenimiento y fin de soporte de AWS Health API, vinculando automáticamente cada evento con los recursos afectados del inventario.
La recolección se ejecuta en paralelo usando un ThreadPoolExecutor con 10 workers, lo que reduce drásticamente el tiempo total de escaneo en entornos con muchas cuentas y servicios.
Motor de alertas configurable
El sistema de alertas es uno de los componentes más sofisticados del proyecto. En lugar de hardcodear reglas en el código, las alertas se definen en YAML con una sintaxis expresiva.
El motor soporta multiples operadores distintos:
| Categoría | Operadores |
|---|---|
| Igualdad | `equals`, `not_equals` |
| Numérico | `greater_than`, `less_than`, `greater_or_equal`, `less_or_equal`, `less_than_field` |
| Texto | `contains`, `not_contains`, `matches` (regex), `not_matches` (regex) |
| Listas | `in_list`, `not_in_list |
| Especial | `contains_field_not_equals` |
Las alertas soportan **condiciones previas** (`condition`): una regla solo se evalúa si el recurso cumple una condición adicional. Esto permite, por ejemplo, alertar sobre RDS sin Multi-AZ únicamente en cuentas de producción.
El campo `field` soporta notación de punto para acceder a campos JSON anidados (`extra.cdc_latency_seconds`, `extra.tags.Environment`), lo que da una flexibilidad enorme sin necesidad de modificar el esquema de base de datos.
Las alertas se evalúan automáticamente al finalizar cada ciclo de recolección. El sistema también gestiona supresiones: una alerta suprimida no vuelve a aparecer aunque el recurso siga en estado incorrecto, lo que evita el ruido de falsos positivos conocidos.
API REST con FastAPI
La API expone todos los datos a través de endpoints RESTful con:
- Paginación en todos los endpoints de listado (hasta 500 items por página)
- Filtrado por cuenta, servicio, severidad
- Búsqueda avanzada con soporte para campos JSON anidados (`search_fields=name,extra.instance_type`)
- Ordenamiento configurable por cualquier campo
- Documentación automática con Swagger UI y ReDoc generada por FastAPI/OpenAPI
- Validación de esquemas automática con Pydantic v2
Autenticación corporativa LDAP + JWT
El sistema se integra con Active Directory corporativo mediante el protocolo LDAP. El flujo de autenticación es:
- 1. El usuario envía credenciales al endpoint `/api/auth/login`
- 2. El backend autentica contra AD usando `ldap3`
- 3. Verifica que el usuario pertenece a alguno de los grupos autorizados (`allowed_groups`)
- 4. Genera un JWT firmado con expiración configurable
- 5. El frontend almacena el token en una cookie segura y lo inyecta en cada petición
El control de acceso a endpoints de escritura (suprimir alertas, aplicar tags) se implementa mediante un **dependency injection** de FastAPI que valida el JWT en cada petición.
Persistencia con SQLite optimizado
La elección de SQLite como base de datos fue deliberada: el sistema corre en una única instancia EC2 y SQLite elimina la necesidad de gestionar un servidor de base de datos separado. Para garantizar el rendimiento con decenas de miles de recursos:
- Índices en campos de filtrado frecuente (`service`, `account_name`, `last_updated`)
- Búsqueda en campos JSON usando `json_extract()` de SQLite
- Connection pooling con timeout configurable
- Transacciones con rollback automático en caso de error
El esquema es intencionalmente flexible: los atributos específicos de cada servicio se almacenan en un campo `extra` de tipo JSON, lo que permite añadir nuevos atributos sin migraciones de esquema.
Logging y operaciones
- Rotación automática de logs por tamaño (10 MB por archivo, 5 backups)
- Retención configurable (30 días por defecto)
- Limpieza periódica automática de logs antiguos
- Health check endpoint (`/api/healthz`) para integración con sistemas de monitorización
Frontend — Angular
Arquitectura moderna con standalone components
El frontend está construido con Angular usando la arquitectura de standalone components (sin NgModules), que es el estándar actual del framework. Esto reduce el boilerplate, mejora el tree-shaking y hace el código más mantenible.
Se usa OnPush change detection en todos los componentes, lo que significa que Angular solo re-renderiza cuando las referencias de los inputs cambian, no en cada ciclo de detección. En tablas con cientos de recursos, esto marca una diferencia de rendimiento notable.
Módulos funcionales
La aplicación está organizada en módulos de funcionalidad bien delimitados:
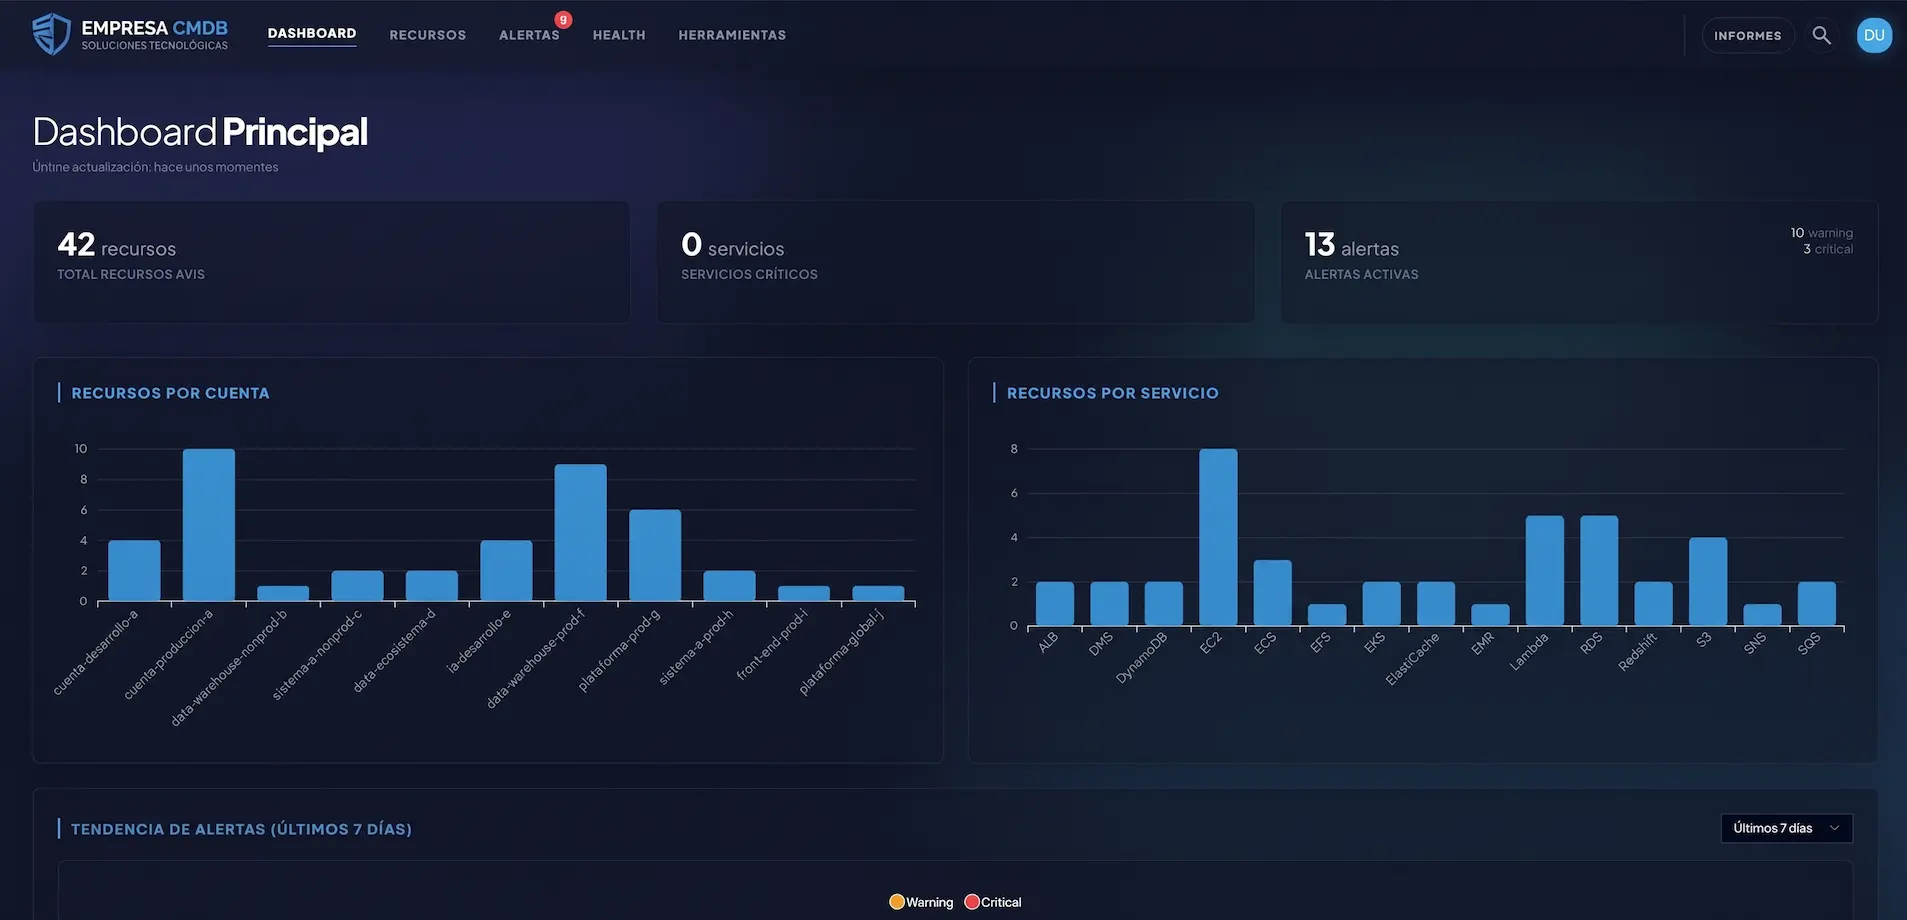
Dashboard — Vista principal con KPIs en tiempo real:
- Total de recursos por servicio con iconos AWS
- Distribución de alertas por severidad (críticas, warnings, info)
- Gráfico de tendencia de alertas de los últimos 7/14/30 días (ApexCharts)
- Estado de los servicios configurados
Inventario de recursos — Tablas por servicio con:
- Columnas específicas por tipo de servicio (EC2 muestra instance_type, state, IP; RDS muestra engine, Multi-AZ, storage)
- Filtros por cuenta y búsqueda en tiempo real
- Exportación a Excel/CSV
- Navegación al detalle del recurso
Gestión de alertas — Lista de alertas activas con:
- Filtrado por severidad y servicio
- Acción de supresión directamente desde la tabla
- Indicador visual de severidad (colores semáforo)
AWS Health — Eventos de mantenimiento y fin de soporte con:
- Vinculación a los recursos afectados del inventario
- Navegación directa al recurso desde el evento
Búsqueda global — Activable con `Ctrl+K`, busca en tiempo real en todos los recursos de todos los servicios simultáneamente.
Herramientas — Panel de utilidades administrativas:
- Generador de tags de offhours para Cloud Custodian con validación de formato
- Asistente de nomenclatura de recursos
- Consola SQL para consultas ad-hoc sobre el inventario
Informes — Generación de documentos Word (.docx) con el inventario filtrado, usando la librería `docx`.
Impacto y métricas
- Visibilidad completa sobre más de 12 cuentas AWS desde una única interfaz, eliminando la necesidad de acceder a cada cuenta individualmente en la consola de AWS.
- Detección automática de incumplimientos de políticas corporativas: instancias paradas, bases de datos sin Multi-AZ, buckets sin cifrado, runtimes obsoletos, etc.
- Reducción del tiempo de respuesta ante eventos de AWS Health: los equipos ven directamente qué recursos de su inventario están afectados sin tener que cruzar información manualmente.
- Automatización de offhours: la validación automática del formato de tags de Cloud Custodian garantiza que las políticas de apagado automático funcionen correctamente, con ahorro directo en costes de infraestructura.
Galería
Galería de AWS CMDB. Usa las flechas o desliza para cambiar de imagen. Pulsa Enter o haz clic para ampliar.